Hay tres archivos o etiquetas que casi todo el mundo toca al montar un sitio y que casi todo el mundo confunde en algún momento: robots.txt, la regla noindex y el sitemap. Parecen tres formas de decirle a Google lo mismo y no lo son. Cada una actúa en una fase distinta del proceso, y cuando se usan como si fueran intercambiables, se anulan entre sí.
Lo que sigue es un mapa de responsabilidades: qué controla cada una según la documentación de Google, qué no controla, y cómo combinarlas sin pisarse.
Tres fases, tres herramientas
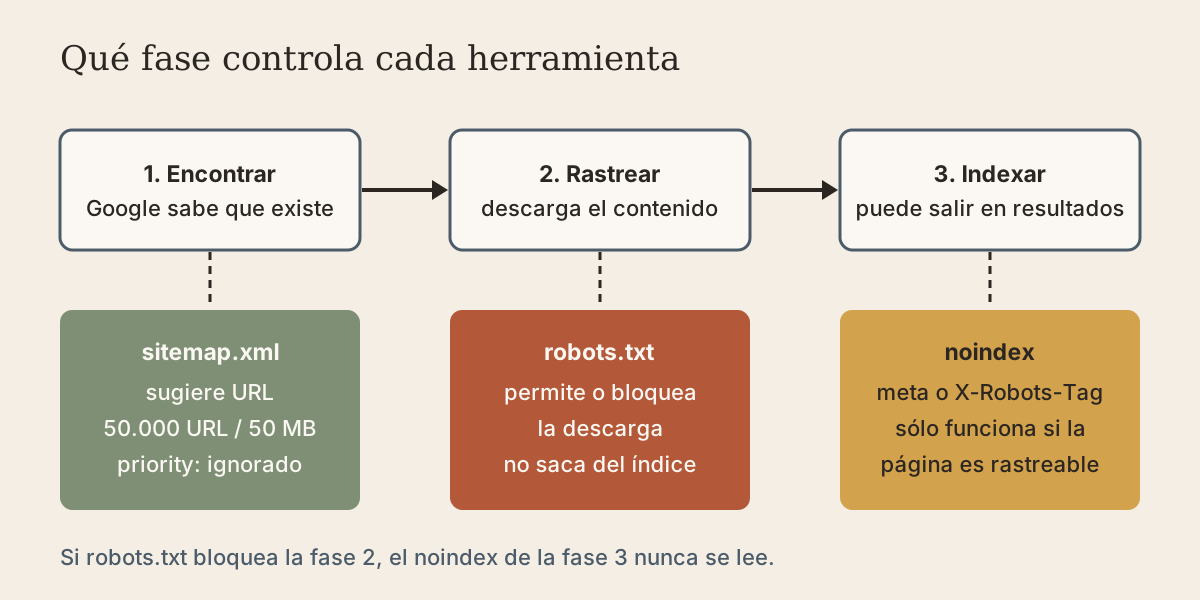
Para que una página aparezca en Google pasan, simplificando, tres cosas: Google encuentra la URL (por un enlace o un sitemap), la rastrea (descarga su contenido) y decide si la indexa (la guarda para mostrarla en resultados). Cada herramienta interviene en una sola fase:
- Sitemap → descubrimiento. Es una lista de URL que le sugieres a Google. No obliga a nada: la documentación dice expresamente que no asegura que todas se rastreen ni se indexen.
- robots.txt → rastreo. Dice qué URL puede descargar cada rastreador. Google lo describe como una forma de evitar sobrecargar el sitio con peticiones, y añade que no es un mecanismo para mantener una página fuera de Google.
- noindex → indexación. Es la instrucción para que una página no aparezca en los resultados. Se pone en una etiqueta
metadel HTML o en la cabecera HTTPX-Robots-Tag.
robots.txt: controla el rastreo, no la indexación
Una URL bloqueada en robots.txt puede seguir apareciendo en los resultados. Google lo explica así: si otras páginas enlazan a ella, puede indexar la URL sin haber visto su contenido, y el resultado se mostrará sin descripción. Es decir, bloquear el rastreo impide que Google lea la página, no que sepa que existe.
Para qué sirve, entonces: para ahorrar rastreo en zonas sin valor para el buscador (resultados de búsqueda interna con parámetros infinitos, carritos, áreas de pruebas) y para evitar que un rastreador sature el servidor. Dos detalles de la especificación de Google: el archivo debe estar en la raíz del host (https://www.ejemplo.com/robots.txt) y Google procesa como máximo 500 KiB; lo que pase de ahí se ignora. Y desde el 1 de septiembre de 2019 Google no admite reglas noindex dentro de robots.txt.
# https://www.ejemplo.com/robots.txt
User-agent: *
Disallow: /buscar
Disallow: /carrito/
Disallow: /*?orden=

Sitemap: https://www.ejemplo.com/sitemap.xmlnoindex: controla la indexación, pero necesita rastreo
La documentación de Google es explícita: para que noindex funcione, la página no puede estar bloqueada por robots.txt y tiene que ser accesible para el rastreador. Si Googlebot no puede descargar la página, nunca ve la regla, y la URL puede seguir apareciendo si otros sitios la enlazan.
Hay dos formas de aplicarlo. En el HTML, dentro de <head>:
<meta name="robots" content="noindex">O como cabecera HTTP, que sirve también para archivos que no son HTML, como PDF:
X-Robots-Tag: noindexLa retirada no es inmediata: ocurre cuando Google vuelve a rastrear la página y ve la regla, lo que puede tardar desde días hasta meses según la frecuencia de rastreo de esa URL. Si necesitas que desaparezca ya de los resultados, Search Console tiene una herramienta de retirada temporal, que sirve de puente mientras el noindex hace efecto.
Sitemap: una sugerencia con límites concretos
El sitemap XML es una lista de las URL que quieres que Google conozca. Los datos que da la guía Build and submit a sitemap:
- Un sitemap admite como máximo 50.000 URL o 50 MB sin comprimir, lo que se alcance antes. Si lo comprimes con gzip, el límite de 50 MB sigue contando sobre el tamaño descomprimido. Si te pasas, divídelo y agrupa los archivos en un índice de sitemaps.
- Google usa
<lastmod>sólo si es coherente y verificablemente preciso. Debe reflejar la última modificación significativa del contenido, no la fecha en que se regeneró el archivo. - Google ignora
<priority>y<changefreq>. Siguen siendo válidos en el protocolo, pero no aportan nada para Google. - Debe usar URL absolutas y canónicas, y el archivo, codificación UTF-8.
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.ejemplo.com/articulos/guia-hornos/</loc>
    <lastmod>2026-09-14</lastmod>
  </url>
  <url>
    <loc>https://www.ejemplo.com/articulos/limpieza-juntas/</loc>
  </url>
</urlset>
La segunda URL no lleva lastmod: si no conoces la fecha real, es mejor omitirla que inventarla. Un generador que pone la fecha de hoy en todas las URL cada vez que se construye el sitio enseña a Google que ese campo no es fiable en tu sitio.
Puedes declarar el sitemap en robots.txt con la línea Sitemap: y enviarlo en Search Console. Incluye sólo URL que respondan 200, sean canónicas y quieras indexar: una URL con noindex o que redirige dentro del sitemap es una contradicción que Search Console puede señalarte.
Tabla: quiero X → uso Y
| Quiero… | Uso | No uses |
|---|---|---|
| Que una página no salga en Google | noindex (meta o cabecera), con la página rastreable | robots.txt |
| Que nadie sin permiso pueda verla | Contraseña o inicio de sesión (401/403) | noindex ni robots.txt: ambos son públicos y voluntarios para el rastreador |
| Que Google no gaste rastreo en URL con parámetros infinitos | robots.txt (Disallow) | noindex solo (Google tiene que rastrear para verlo) |
| Que Google descubra antes mis artículos nuevos | Sitemap con lastmod real y enlaces internos | priority o changefreq |
| Que un PDF no se indexe | Cabecera X-Robots-Tag: noindex | Una etiqueta meta (los PDF no tienen <head>) |
| Retirar una página que ya no existe | 404 o 410 (y quitarla del sitemap) | robots.txt |
| Consolidar duplicados en una URL | 301 o rel="canonical" | noindex en las copias (Google desaconseja usarlo para elegir canónica) |
| Ocultar algo con urgencia de los resultados | Herramienta de retirada de Search Console + noindex o eliminación | Esperar sólo a robots.txt |
Los casos de duplicados y versiones de una misma página están desarrollados en HTTPS, www y canonical, y la elección entre 404, 410 y redirección, en 200, 301, 404, 410 y soft 404.
Caso práctico: noindex bloqueado por robots.txt
Caso práctico hipotético
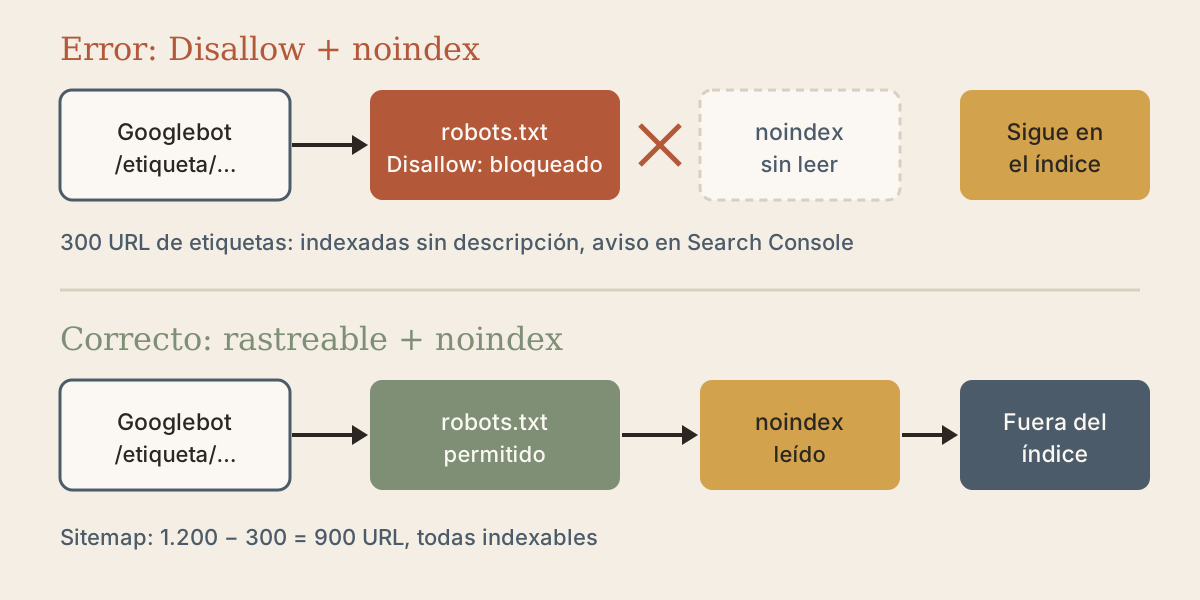
Supongamos un sitio con 1.200 URL indexadas, de las cuales 300 son páginas de etiquetas (/etiqueta/…) con poco contenido. El responsable decide sacarlas del índice y hace dos cosas el mismo día: añade <meta name="robots" content="noindex"> a la plantilla de etiquetas y, «para asegurarse», añade Disallow: /etiqueta/ a robots.txt. Además, las páginas siguen en el sitemap.
Qué pasa: Googlebot deja de rastrear /etiqueta/ y nunca descarga la versión con noindex. Las 300 URL siguen en el índice con el contenido antiguo y, con el tiempo, pueden mostrarse sin descripción. En el informe de indexación de Search Console pueden aparecer como indexadas aunque bloqueadas por robots.txt (Indexed, though blocked by robots.txt), y el sitemap contradice a robots.txt.
Corrección en tres pasos:
- Quitar
Disallow: /etiqueta/de robots.txt y mantener elnoindex. - Sacar las 300 URL del sitemap: el sitemap queda con 1.200 − 300 = 900 URL, todas indexables.
- Esperar a que Google vuelva a rastrearlas y comprobar en el informe de indexación de páginas que pasan a «Excluida por una etiqueta "noindex"» (o un texto equivalente).
Si, una vez retiradas, se quiere ahorrar rastreo, se puede volver a añadir el Disallow. Pero sólo después: si se añade antes, se repite el problema con cualquier página que todavía no se haya retirado.
Lista de comprobación antes de publicar cambios
- Abre
/robots.txten el navegador y confirma que no bloquea nada que quieras indexar ni tus CSS y JS. - Comprueba que ninguna URL con
noindexestá bloqueada en robots.txt. - Busca en el código fuente de tus páginas principales que no haya un
noindexolvidado del entorno de pruebas (fallo frecuente al publicar). - Revisa las cabeceras con
curl -I: unX-Robots-Tag: noindexconfigurado en el servidor no se ve en el HTML. - Confirma que el sitemap tiene menos de 50.000 URL y 50 MB sin comprimir, sólo URL canónicas con 200 y sin
noindex. - Si usas
lastmod, verifica que cambia sólo cuando cambia el contenido. - Declara el sitemap en robots.txt y envíalo en Search Console.
- Usa la inspección de URL de Search Console para ver cómo interpreta Google una página concreta.
Cuándo no hace falta tocar nada
Un sitio pequeño, con unas decenas de páginas bien enlazadas entre sí, puede funcionar perfectamente con un robots.txt casi vacío (o sin él: si no existe y responde 404, Google entiende que no hay restricciones) y un sitemap generado automáticamente sin lastmod. Añadir reglas «por si acaso» es la forma más común de crear los problemas descritos arriba. Si tu sitio es estático, la mayoría de generadores crean el sitemap por ti; en ¿Sitio estático o WordPress? comparamos qué hace cada opción de serie.
Cómo se ha elaborado este artículo
El artículo se basa en la documentación de Google Search Central sobre robots.txt, la regla noindex, la creación de sitemaps y la especificación de robots.txt que interpreta Google, además del protocolo Sitemaps (sitemaps.org) y RFC 9309. Los archivos de ejemplo y el caso práctico son ilustrativos, con un sitio y unas cifras hipotéticas; no hay pruebas propias detrás de este texto.
Fuentes consultadas
- Google Search Central: Introduction to robots.txt
- Google Search Central: Block Search indexing with noindex
- Google Search Central: Build and submit a sitemap
- Google Search Central: How Google interprets the robots.txt specification
- IETF: RFC 9309: Robots Exclusion Protocol
- sitemaps.org: Sitemaps XML format
¿Has visto un dato erróneo o desactualizado? Escribe a [email protected] indicando la URL. Las correcciones se aplican según la política editorial.