Antes de enviar una sola letra de contenido, el servidor contesta con un número de tres cifras. Ese número es lo primero que lee Googlebot y, muchas veces, lo único que necesita para decidir qué hacer con la URL: indexarla, pasar sus señales a otra dirección, dejar de visitarla o volver más tarde. Si el número no coincide con lo que ve una persona en pantalla, el buscador se queda con el número.
Aquí va lo justo: qué significa cada código que de verdad vas a usar, cómo lo trata Google según su documentación y qué debe responder cada tipo de URL de un sitio pequeño o mediano.
Lo que Google hace con cada familia de códigos
Google mantiene una página de referencia (How HTTP status codes, and network and DNS errors affect Google Search) con los códigos que más encuentran sus rastreadores. Resumida, sin adornos:
- 2xx (éxito). Google pasa el contenido al sistema de indexación. Un 200 no asegura que la página se indexe: sólo la hace candidata. Un 204 (sin contenido) se interpreta como que no hay nada que indexar y puede aparecer como soft 404 en Search Console.
- 301 y 308 (redirección permanente). Googlebot sigue la redirección y el sistema de indexación lo toma como una señal fuerte de que la URL de destino debe ser la canónica.
- 302 y 307 (redirección temporal). También se siguen, pero cuentan como señal débil de canonicidad. Google trata igual 301 y 308, y 302 y 307, aunque en HTTP no signifiquen exactamente lo mismo.
- 304 (no modificado). Indica que el contenido es el mismo que en el último rastreo; Google reutiliza la versión que ya tenía.
- 4xx salvo 429. Todos se tratan igual: el contenido no existe. Si la URL estaba indexada, se retira del índice; si era nueva, no se procesa. La frecuencia de rastreo de esa URL baja poco a poco.
- 429 y 5xx. Se interpretan como un servidor en apuros: Google reduce temporalmente el ritmo de rastreo, en proporción al número de URL que fallan. Las URL ya indexadas se mantienen al principio, pero si el error persiste acaban retiradas.
Dos datos más de la misma documentación: Googlebot sigue como máximo 10 saltos de redirección cuando rastrea contenido web general, y el contenido de la URL que redirige se ignora (sólo cuenta el destino final). Los tiempos de espera agotados, las conexiones cortadas y los errores de DNS se tratan de forma parecida a un 5xx.
El soft 404: cuando la página dice una cosa y el servidor otra
Un soft 404 («404 blando») es una URL que devuelve 200 pero cuyo contenido le dice al usuario que no hay nada: «Página no encontrada», una plantilla vacía, un listado sin resultados. Google detecta estos casos y los señala en el informe de indexación de páginas de Search Console. El problema no es sólo estético: esas URL consumen rastreo sin aportar nada.
Las causas típicas en sitios pequeños son tres: una plantilla de error que el servidor entrega con 200 (frecuente en aplicaciones de una sola página y en algunos alojamientos), redirecciones hechas en JavaScript que no llegan al rastreador como esperas, y páginas de categoría o búsqueda que se quedan vacías. Google también puede considerar soft 404 una página cuyo contenido principal depende de recursos que no se pueden cargar.
La solución depende de la intención. Si la página no existe, devuelve 404 o 410; si se ha movido, redirige con 301 desde el servidor; si existe pero está vacía de forma temporal, añade contenido útil o márcala con noindex.
Tabla: situación real → código correcto
| Situación | Código | Por qué |
|---|---|---|
| Artículo publicado y vigente | 200 | Contenido real que quieres en el índice. |
| Artículo movido a otra URL (cambio de slug, fusión con otro) | 301 | Señal fuerte de que la nueva URL es la canónica; los enlaces antiguos siguen funcionando. |
| Página de campaña que vuelve en unas semanas; mientras, mandas a otra sección | 302 | El destino es provisional y quieres conservar la URL original como canónica. |
| Artículo eliminado para siempre, sin sustituto razonable | 410 (o 404) | Dice que no existe; 410 añade «y no va a volver». |
| Artículo eliminado con un sustituto muy parecido | 301 al sustituto | Sólo si el destino responde a la misma necesidad. Redirigir todo a la portada suele acabar tratado como soft 404. |
| Borrador o vista previa sin publicar | 404, o 401/403 tras inicio de sesión | No debe ser accesible ni rastreable. Un borrador con 200 y una URL adivinable puede acabar indexado. |
| URL inventada o mal escrita | 404 | Nunca 200 con una plantilla de «no encontrado». |
| Búsqueda interna sin resultados | 200 con noindex, o 404 | Una página vacía con 200 indexable es el soft 404 de manual. |
| Mantenimiento programado de unas horas | 503 + Retry-After | Indica indisponibilidad temporal; lo indexado se conserva si la parada es corta. |
| Recurso sin cambios desde la última visita, con petición condicional | 304 | Ahorra transferencia y procesamiento; Google reutiliza lo que ya tenía. |
| Servidor saturado por el rastreo | 503 o 429, temporalmente | Google baja el ritmo. Nunca 401 o 403 para frenar a Googlebot. |
Mantenimiento con 503 y Retry-After
Durante una parada planificada, Google recomienda devolver 503 en lugar de un 200 con un mensaje de «Volvemos pronto» o, peor, un 404. La cabecera Retry-After es opcional y admite dos formatos según RFC 9110: un número de segundos o una fecha HTTP. Googlebot puede usarla como orientación para decidir cuándo volver, sin compromiso de respetarla al minuto.
El límite está en la duración. La guía de errores de rastreo de Google advierte que devolver códigos de «no disponible» durante más de unos pocos días hará que Google ralentice o detenga el rastreo de esas URL de forma duradera, y la referencia de códigos de estado recuerda que, si el error persiste, las URL indexadas acaban retiradas. Para frenos de emergencia, Google habla de un par de horas o uno o dos días. El 503 sirve para horas, no para semanas.
Ejemplo de cálculo: ventana de mantenimiento
Supongamos una migración de base de datos prevista de 02:00 a 06:00 UTC del 3 de noviembre de 2026. Son 4 horas, es decir, 4 × 3.600 = 14.400 segundos. La respuesta durante la parada podría ser:
HTTP/1.1 503 Service Unavailable
Retry-After: 14400
Content-Type: text/html; charset=utf-8
O, con fecha absoluta: Retry-After: Tue, 03 Nov 2026 06:00:00 GMT. Si la migración se complica y se alarga más de un día, conviene servir al menos una versión de sólo lectura con 200 antes que prolongar el 503: Google no publica un plazo exacto a partir del cual retira las URL.
Cadenas de redirección: cuántos saltos son demasiados
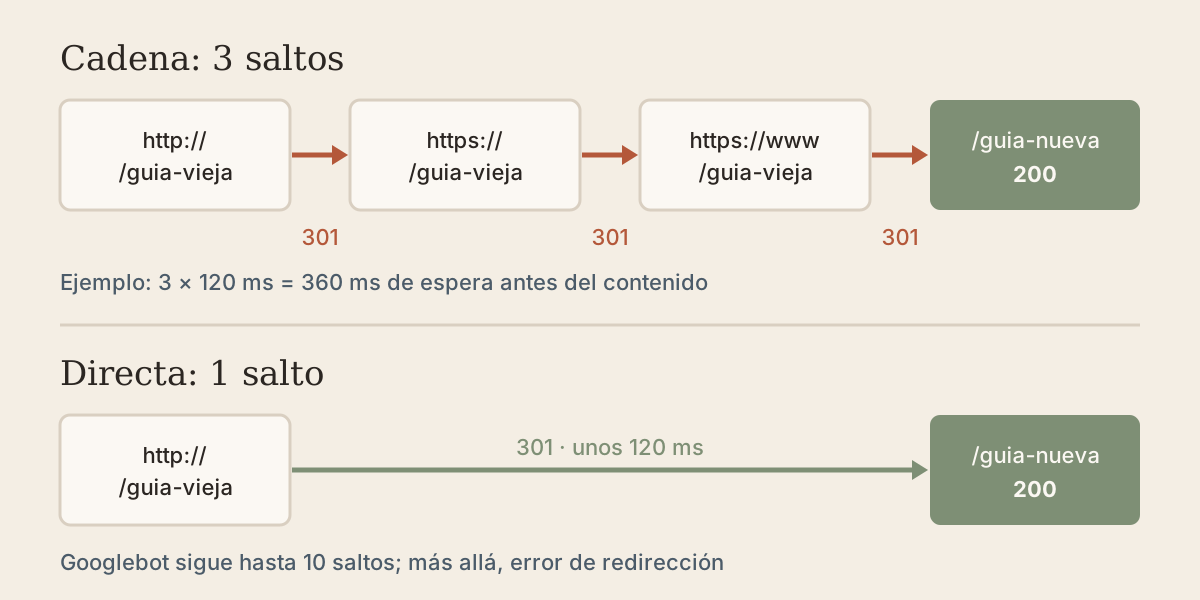
Googlebot sigue hasta 10 saltos, pero cada salto es una petición más para el navegador del usuario y para el rastreador. Las cadenas suelen formarse sin querer, por capas: primero se fuerza HTTPS, luego se añade el www, luego cambia el slug de un artículo. El orden de esas reglas está en HTTPS, www y canonical.
Ejemplo de cálculo: una cadena de tres saltos
Un enlace antiguo apunta a http://ejemplo.com/guia-vieja. El recorrido es:
http://ejemplo.com/guia-vieja→ 301 →https://ejemplo.com/guia-viejahttps://ejemplo.com/guia-vieja→ 301 →https://www.ejemplo.com/guia-viejahttps://www.ejemplo.com/guia-vieja→ 301 →https://www.ejemplo.com/guia-nueva(200)
Si cada ida y vuelta cuesta, digamos, 120 ms en una conexión móvil, el usuario espera unos 3 × 120 = 360 ms antes de empezar a recibir la página. Con una regla que lleve directamente de la URL original al destino final queda un salto: unos 120 ms. Las cifras de latencia son ilustrativas; la conveniencia de reducir saltos no lo es.
Comprobarlo con curl -I
El navegador oculta los códigos: sigue redirecciones en silencio y muestra la plantilla de error sin decir con qué número llegó. Para ver lo que ve un rastreador, usa curl desde la terminal. La opción -I pide sólo las cabeceras (con una petición HEAD):
curl -I https://www.ejemplo.com/guia-nuevaLa primera línea de la respuesta es la que importa, por ejemplo HTTP/2 200. Para ver la cadena completa de redirecciones, añade -L, que sigue cada salto y muestra las cabeceras de todos:
curl -sIL http://ejemplo.com/guia-vieja | grep -iE "^(HTTP|location)"Algunos servidores responden distinto a HEAD que a GET. Si sospechas algo raro, pide la página completa, descarta el cuerpo y muestra sólo el código final y el número de redirecciones:
curl -s -o /dev/null -L -w "%{http_code} tras %{num_redirects} saltos\n" http://ejemplo.com/guia-viejaTres pruebas que conviene hacer en cualquier sitio nuevo: una URL inventada (/esto-no-existe-123) debe dar 404; la versión http:// sin www debe llegar al destino en un salto; y una búsqueda interna absurda no debe devolver un 200 indexable. Para saber qué obtuvo Googlebot en concreto, la herramienta de inspección de URL de Search Console muestra el estado del último rastreo.
Ruta de decisión para cualquier URL
Cuando dudes, recorre estas preguntas en orden. La primera que tenga una respuesta clara decide el código.
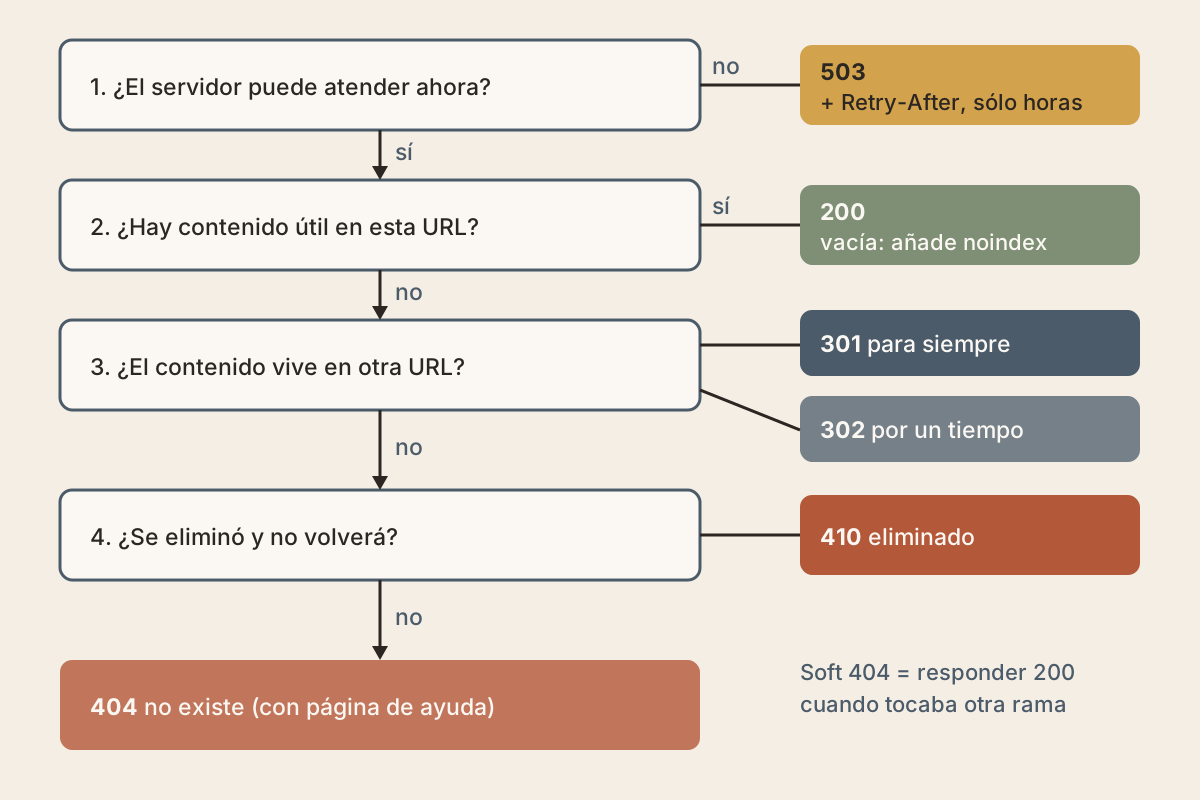
- ¿El servidor puede atender ahora mismo? Si no, por mantenimiento o sobrecarga: 503 (con
Retry-Aftersi conoces la duración), y sólo durante horas. - ¿Existe en esta URL un contenido útil para quien llega? Sí: 200. Si existe pero está vacío o no quieres que se indexe: 200 con
noindex. - ¿Ese contenido vive ahora en otra URL? Para siempre: 301 (o 308). Provisionalmente: 302 (o 307). Redirige al equivalente, no a la portada por costumbre.
- ¿Se ha eliminado a propósito y no volverá? 410.
- ¿Nada de lo anterior? 404, con una página de error que ayude a seguir navegando.
Cuándo no merece la pena afinar tanto
Si tu sitio tiene unas decenas de páginas y ningún enlace externo apunta a las URL antiguas, discutir entre 404 y 410 es tiempo mal invertido: Google los trata igual. Tampoco necesitas implementar 304 a mano si usas un alojamiento estático o una CDN; la mayoría gestiona las peticiones condicionales con ETag o Last-Modified por su cuenta. Donde sí compensa gastar media hora es en la plantilla de error (que devuelva 404 de verdad) y en eliminar cadenas de redirección.
Si todavía estás eligiendo plataforma, ten en cuenta cuánto control te da sobre estas respuestas; lo comparamos en ¿Sitio estático o WordPress?. Y si lo que quieres es sacar una página del índice sin borrarla, el siguiente paso está en robots.txt, noindex y sitemap: qué controla cada uno.
Cómo se ha elaborado este artículo
Este artículo se basa en la documentación de Google Search Central sobre cómo afectan los códigos de estado HTTP y los errores de red y DNS a la Búsqueda de Google, en su guía de redirecciones, en su guía de errores de rastreo, en su entrada sobre paradas planificadas y en la especificación HTTP (RFC 9110). Las URL, tiempos y cadenas de redirección que aparecen son ejemplos ilustrativos; no hay pruebas propias detrás de este texto.
Fuentes consultadas
- Google Search Central: How HTTP status codes, and network and DNS errors affect Google Search
- Google Search Central: Redirects and Google Search
- Google Search Central: Troubleshoot Google Search crawling errors
- Google Search Central Blog: How to deal with planned site downtime
- IETF: RFC 9110: HTTP Semantics
¿Has visto un dato erróneo o desactualizado? Escribe a [email protected] indicando la URL. Las correcciones se aplican según la política editorial.